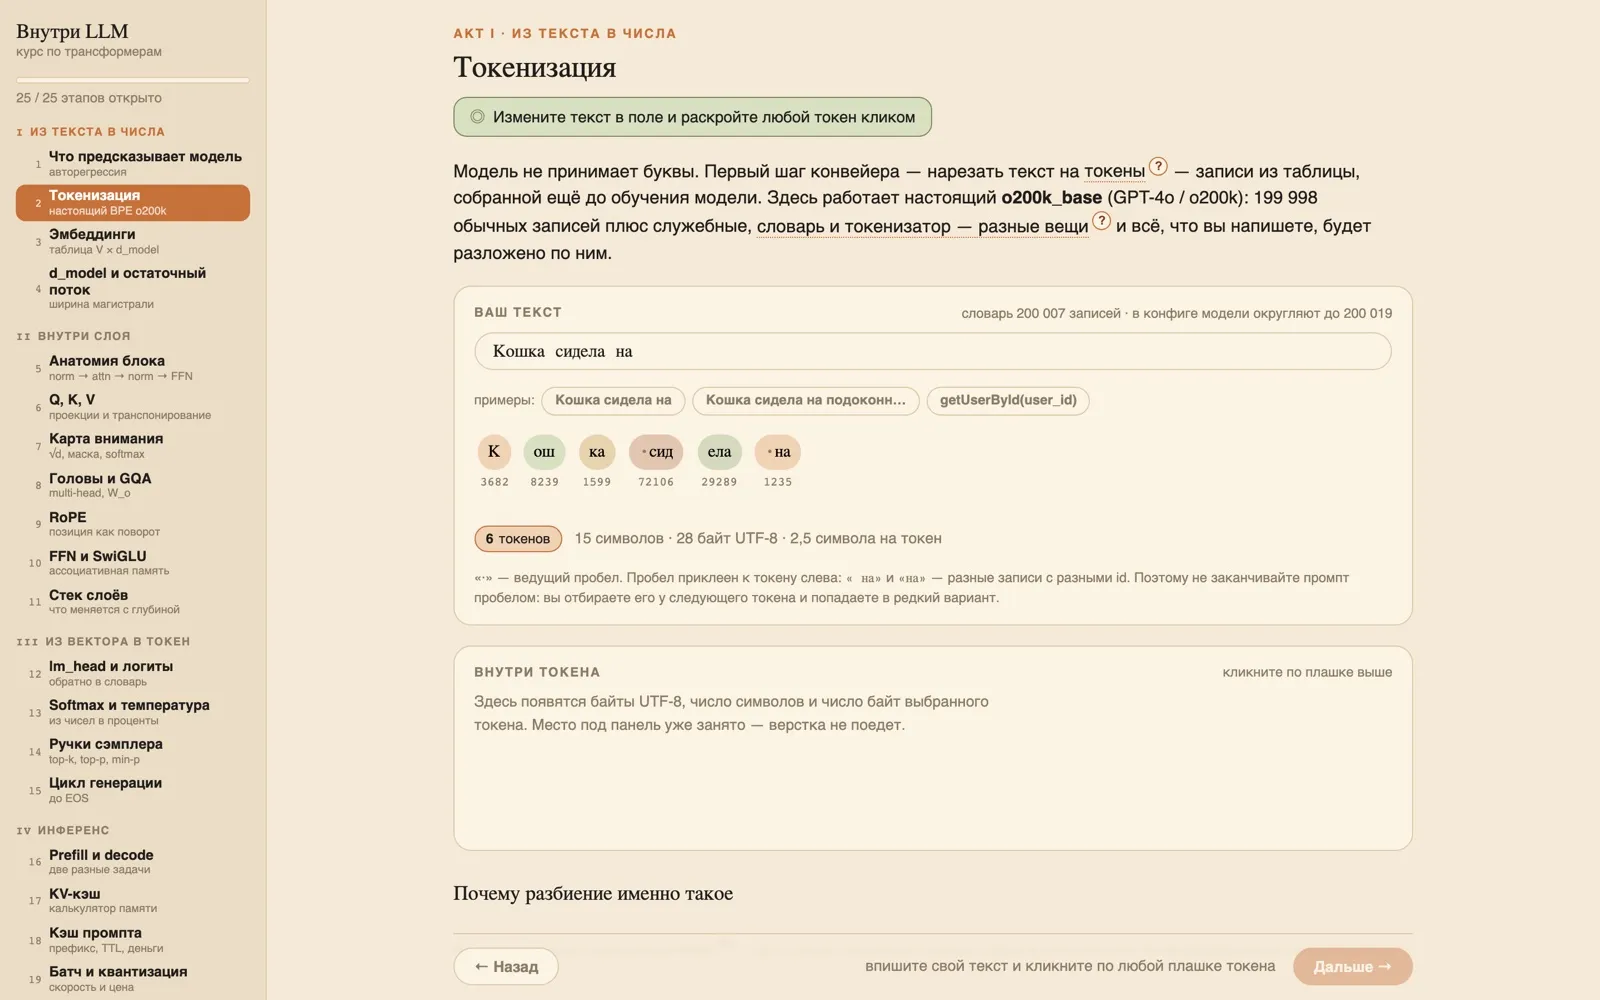
Зачем
Я хотел понимать LLM не на уровне «нейросеть предсказывает следующее слово», а на уровне размерностей: что именно умножается на что, где лежат параметры, во что упирается инференс и почему кэш промпта экономит деньги. Статьи и лекции давали ощущение понимания, которое рассыпалось при первом же вопросе «а сколько это байт?».
Второй мотив — команда. Мне нужно было объяснить коллегам, как устроена модель, которую мы раскатываем, и чем prefill отличается от decode. Слайды для этого плохо подходят: их листают, а не проходят. Так появилась идея сделать курс, где нельзя нажать «дальше», не сделав что-то руками.
Что это
25 этапов в шести актах: от строки текста до обученных весов.
| Акт | Этапы |
|---|---|
| I · Из текста в числа | авторегрессия, токенизация, эмбеддинги, d_model и остаточный поток |
| II · Внутри слоя | анатомия блока, Q/K/V, карта внимания, головы и GQA, RoPE, SwiGLU, стек |
| III · Из вектора в токен | lm_head и логиты, softmax и температура, ручки сэмплера, цикл генерации |
| IV · Инференс | prefill и decode, KV-кэш, кэш промпта, батч и квантизация |
| V · Обучение | карта весов, ошибка и перплексия, градиент и оптимизатор, SFT и RLHF, LoRA |
| VI · Итог | полная карта конвейера и экзамен из 12 вопросов |
Каждый экран объясняет один механизм и открывает кнопку «Дальше» только после реального
действия: изменить текст и кликнуть по токену, подвигать температуру, пройти подшаги
умножения матриц, ответить на вопрос. Прогресс хранится в localStorage, на сервер
ничего не уходит.
Что здесь по-настоящему
Главное правило курса: демонстрационные величины помечены прямо в интерфейсе, а всё остальное честное.
- Токенизатор настоящий:
o200k_baseиз пакетаgpt-tokenizer. Id, которые видит пользователь, те же, что увидит GPT-4o: «Кошка сидела на» →3682, 8239, 1599, 72106, 29289, 1235. - Спеки моделей взяты из
config.jsonна HuggingFace. Счётчик параметров сходится с официальными числами в пределах 0,7 % для 15 моделей, включая MoE. - Обучение живое: двухслойная сеть с аналитическими градиентами, проверенными численным дифференцированием. За 200 шагов AdamW loss падает с ≈3,7 до ≈0,8 прямо в браузере.
- Арифметика инференса сходится с реальностью: KV-кэш Llama 3 8B выходит ровно 131 072 байта на токен, как и должно быть при 32 слоях, 8 KV-головах и d_head = 128.
Тот же калькулятор, перенесённый сюда в виде виджета:
2 × 32 слоёв × 8 KV-голов × 128 × 2 Б = 131 072 Б на токен · GQA: в 4 раза меньше, чем было бы с MHA
- веса
- 15 ГиБ
- KV-кэш, 8K × 1
- 1 ГиБ
- итого
- 16 ГиБ
веса кэш · засечки — память одного ускорителя
Как устроен код
Vue 3 и Vite, никакого бэкенда. Карта курса — чистые данные без импорта компонентов,
поэтому состояние знает про этапы, этапы про состояние, и циклического импорта нет.
Каждый этап — один файл, вся математика — в пяти модулях lib/: токенизатор, демо-линал
внимания и FFN, спеки моделей, арифметика инференса и настоящий градиентный спуск.
Деплой такой же, как у этого сайта: статика собирается на node:22-alpine, отдаётся
через nginx в Docker, Coolify раскатывает по docker-compose.yaml, TLS на Traefik.
Что дальше
Курс закрывает путь «текст → токен» и базовую экономику инференса. Следующий слой — то, чем я занимаюсь на работе: раскатка моделей, батчинг, спекулятивный декодинг, наблюдаемость. Об этом будут отдельные статьи в теме AI-инженерия.