Внутри LLM: что происходит между промптом и следующим токеном
Прогулка по конвейеру языковой модели с настоящими числами: токены, эмбеддинги, блок трансформера, softmax и сэмплер, KV-кэш и обучение. С двумя интерактивами прямо в тексте.
Полгода назад я поймал себя на том, что «понимаю, как работают LLM», но не могу ответить на вопрос «сколько байт занимает контекст в 8 тысяч токенов у Llama 3 8B». Понимание было на уровне метафор: «внимание смотрит на важные слова», «модель предсказывает следующее слово». Метафоры не конвертируются в байты, миллисекунды и доллары, а именно в них живёт работа инженера, который эту модель раскатывает.
Так появился «Внутри LLM»: интерактивный курс из 25 этапов, где каждый
экран объясняет один механизм и не пускает дальше, пока не сделаешь что-то руками. Я делал его для
себя и для команды. Эта статья — прогулка по тому же конвейеру, но текстом. Числа в ней настоящие:
токенизатор o200k_base, спеки моделей из config.json, арифметика инференса, которая сходится с
реальностью. Два интерактива из курса перенесены прямо в текст.
Модель — это функция
Первое, от чего пришлось отучиться: модель не «пишет ответ». За один запуск она делает ровно одно: выдаёт по числу на каждую запись словаря, то есть вероятность того, что именно этот токен идёт следующим. У o200k_base в словаре 200 007 записей, значит на выходе одного прохода 200 007 чисел для последней позиции. Всё.
Текст собирает внешний цикл: выбрали токен, дописали к входу, запустили модель заново. Ответ на 500 токенов — это 500 полных проходов через все слои, один за другим. Никакого состояния между шагами модель не несёт: весь «ход мысли» лежит в тексте, который вы видите на экране.
Отсюда следует вещь, которую я раньше формулировал неправильно. «Модель уверена на 99,5 %, что столица Франции — Париж» не означает, что модель «знает» Париж. Это означает только, что в обучающих данных после «Столица Франции —» стояло одно и то же слово, а после «Кошка сидела на» — сотни разных. Форма распределения — статистика корпуса, а не знание.
Букв на входе нет
Модель не принимает буквы. Первый шаг конвейера — нарезать строку на токены по таблице, собранной ещё до обучения. «Кошка сидела на» у o200k_base превращается в шесть токенов:
К    ош   ка   ·сид   ела   ·на
3682 8239 1599 72106  29289 1235
Точка перед «сид» и «на» — ведущий пробел, он приклеен к токену слева. « на» и «на» — разные записи с разными id. Поэтому промпт не стоит заканчивать пробелом: вы отбираете его у следующего токена и загоняете модель в редкий вариант.
Дальше по конвейеру уедет одно число, id. Ни строки, ни её букв внутри модели больше нет. Отсюда
знаменитые ошибки со счётом букв в «strawberry»: слово приходит как st·raw·berry, и букв «r» в
этих трёх номерах не видно. Это не дефект мышления, а дефект входа.
Токенизация — это ещё и деньги. BPE сливает пары байтов по частоте в корпусе, никакой лингвистики в нём нет. Английские слова попали в таблицу целиком, русские — обрывками морфем. На одном и том же тексте русский обходится в 1,33 раза дороже английского по числу токенов: платите дважды, деньгами за токены и местом в контексте. Даже заглавная буква стоит лишний токен: «кошка» — два токена, «Кошка» — три, потому что с заглавной слово встречалось в корпусе реже.
Номер становится вектором
После токенизации у модели на руках только целые числа. Первое, что она делает, — меняет номер на
вектор фиксированной длины. Это не поиск и не вычисление, а обычная индексация массива: строка
номер 3682 из таблицы E размером словарь × d_model. У модели с словарём 200 000 и d_model 4096
таблица занимает 819 миллионов чисел, в bf16 — полтора гигабайта весов только на вход.
Таблица эмбеддингов — веса модели, а не справочник смыслов. Никто не расставлял в ней слова рядом. Она стартовала со случайных чисел, и строки разъехались по пространству только потому, что так модели было выгоднее предсказывать следующий токен. На инференсе таблица заморожена: из неё только читают.
d_model — длина вектора одного токена и одновременно ширина магистрали, по которой данные
едут через всю модель. Ширина не меняется никогда. Это гиперпараметр: его выбирает человек до
обучения и записывает в config.json. У Llama 3 8B это 4096, у 70B — 8192, у 405B — 16 384.
Каждая матрица модели имеет d_model хотя бы с одной стороны, поэтому поменять его после обучения
нельзя: изменится форма всех до единой матриц, и обученные веса в них не влезут.
Блок: две операции и два сложения
Слой трансформера — это ровно две операции и два сложения:
x ← x + Attention(RMSNorm(x))
x ← x + FFN(RMSNorm(x))
Ключевое слово здесь — стрелка присваивания, а не знак равенства. Ни внимание, ни FFN не получают права заменить поток: они возвращают поправку, и поправка прибавляется к тому, что уже было. Поэлементно, без коэффициентов. Отсюда слово «остаточный поток»: путь от эмбеддинга до последнего слоя — чистая сумма поправок, и именно это позволяет стеку из 80 слоёв обучаться.
Головы, RoPE, SwiGLU — детали внутри этих двух коробок. Пройдём по ним быстро, оставляя числа.
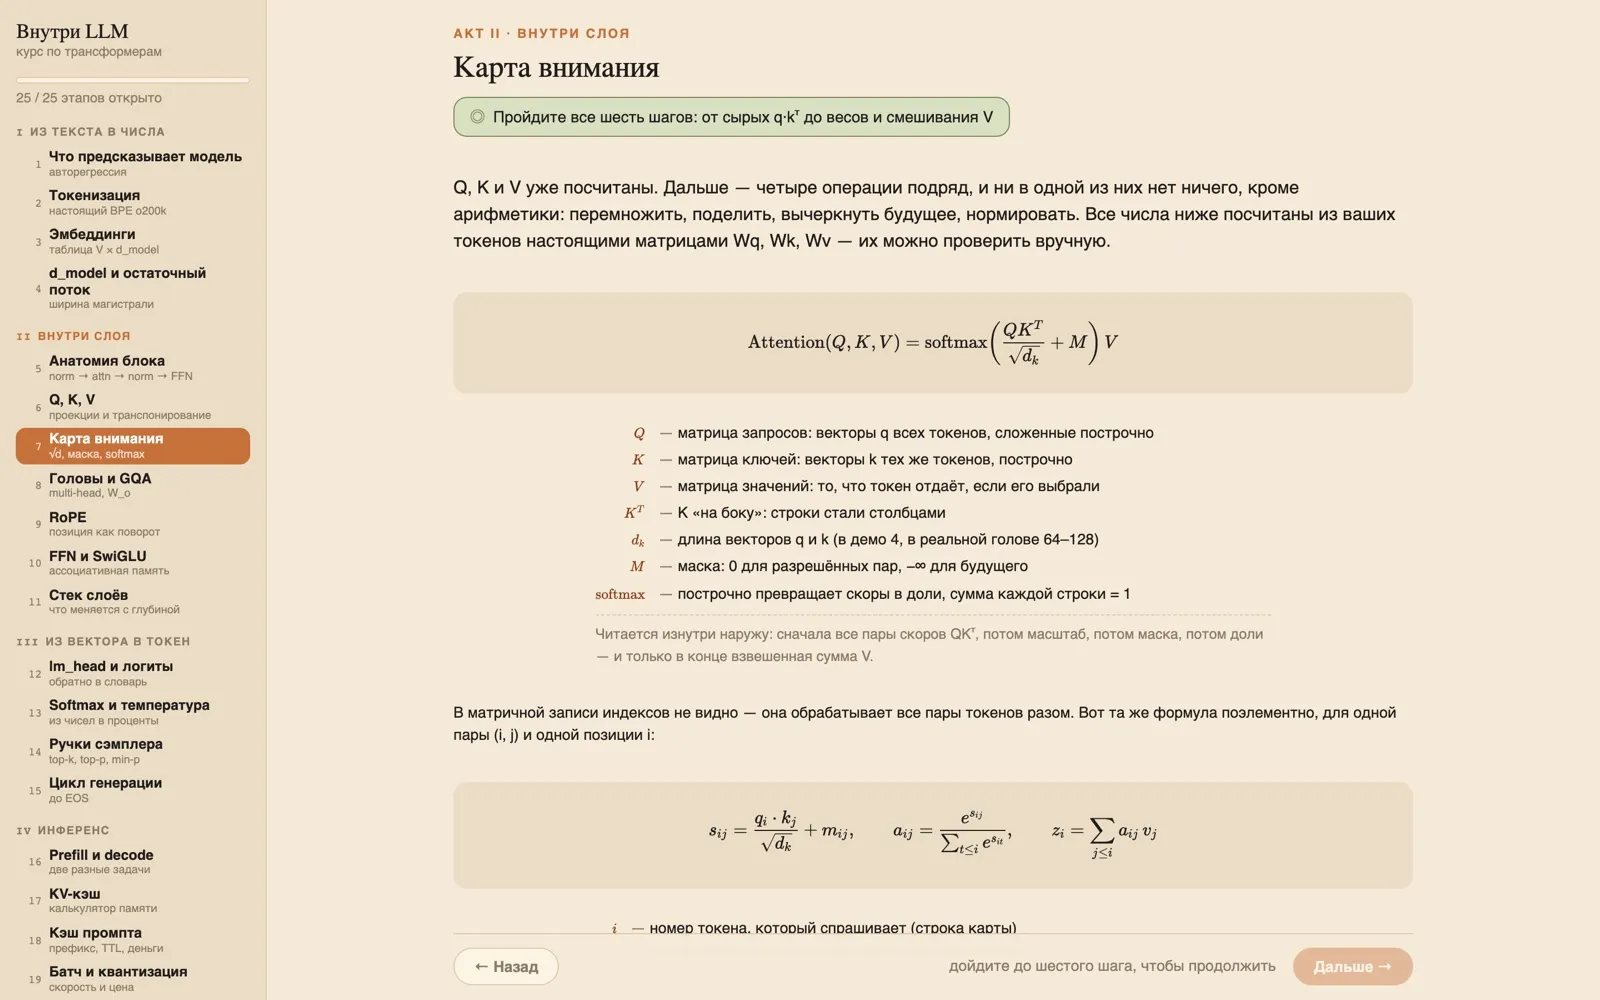
Внимание — единственное место, где позиции обмениваются информацией. Вектор каждого токена
умножается на три обучаемые матрицы и даёт Q, K и V. Это один и тот же вектор, посмотренный
через три разные матрицы; роли задаёт не содержимое, а место, куда вектор потом подставят:
Q — что токен ищет в остальных, K — чем он представляется другим, V — что отдаст, если на него
обратят внимание. Дальше четыре действия подряд: перемножить QKᵀ, поделить на √d_k,
вычеркнуть будущее, нормировать softmax-ом. Результат — взвешенное среднее по прошлым токенам,
где веса взяты из похожести Q и K.
Голов много: у Llama 3 8B их 32, и каждая — полный комплект из трёх матриц со своим взглядом на связи. А вот K и V у неё считаются только в 8 комплектах, по одному на четыре Q-головы. Это GQA, и делают его не ради весов, а ради кэша: именно K и V складываются в KV-кэш и растут с каждым токеном диалога. Это станет главным числом раздела про инференс.
Позиция входит в модель как угол. Без неё внимание видит мешок векторов: оценки для «ела» одинаковы в «кошка ела рыбу» и «рыбу ела кошка». RoPE ничего не прибавляет к вектору, а поворачивает пары координат q и k на угол, пропорциональный позиции. Два поворота при скалярном произведении складываются со знаком, и от абсолютных номеров остаётся только разница: два соседних токена дают одну и ту же оценку и в первой строке промпта, и на стотысячной позиции. Обучаемых параметров у RoPE ноль.
FFN — противоположность внимания: токены между собой не общаются вообще, каждый смотрит в свою память. Вектор расширяется с 4096 до 14 336, проходит через ворота SiLU и сжимается обратно. Это и есть ассоциативная память модели: у каждого из 14 336 нейронов свой «ключ», и токен активирует те, чей ключ на него похож. Внимание решает, о чём речь; FFN достаёт, что про это известно. По параметрам FFN — около 70 % всей Llama 3 8B, внимание — шестая часть.
Глубина — число таких блоков. У Llama 3 8B их 32, у 70B — 80, у 405B — 126. Из остаточного потока можно вытащить вектор после любого слоя, прогнать через выходную матрицу и посмотреть, какой токен получился бы: на первых слоях частотный мусор, к середине проступает тема, к концу распределение собирается вокруг ответа. И раз блоков ровно 32 и каждый выполняется один раз, бюджет вычислений на токен известен заранее: 15 миллиардов операций, одинаково для «Столица Франции —» и для «Докажите, что √2 иррационально». Модель не может «подумать усерднее» над сложным вопросом. Способ ровно один — сгенерировать больше токенов. Reasoning effort в API — это разрешение потратить больше токенов, а не считать тщательнее каждый.
Из вектора обратно в слово
Слои закончились, а слова всё ещё нет. Вектор последней позиции умножается на матрицу
[d_model × V] — у Llama 3 8B это 4096 × 128 256, то есть 525 миллионов умножений на каждый
токен, тогда как эмбеддинг на входе был бесплатной выборкой строки. На выходе логиты: сырые
оценки, не проценты. Смысл несут только разницы. Пары (3,2; 2,8) и (103,2; 102,8) означают ровно
одно и то же, а сравнивать логиты двух разных моделей бессмысленно.
Softmax превращает логиты в проценты: экспонента, потом деление на сумму. Экспонента делает любое число положительным и не переставляет кандидатов местами; разрыв в один логит — это всегда ровно в 2,72 раза, в два логита — в 7,39 раза. А температура — это деление логитов на число до экспоненты. Никакой «креативности» в ней нет и ни одного нового числа в модель она не приносит. Веса при смене температуры не меняются ни на бит.
Между распределением и ответом стоит сэмплер: несколько отсечений в жёстком порядке, потом жребий. Отсечённый токен получает ровно ноль, его масса перераспределяется между выжившими. top-k — грубая ручка, она не смотрит на форму распределения. top-p адаптивна и потому стала настройкой по умолчанию почти везде. min-p считает порог от лидера, поэтому режет много при уверенной модели и почти ничего при сомневающейся. Вся случайность генерации живёт в последнем шаге: сама сеть детерминирована, и если зафиксировать seed, два прогона совпадут.
Попробуйте на семи кандидатах из курса. Переключите промпт с сомневающегося на уверенный и посмотрите, как одни и те же ручки работают по-разному:
| токен | логит | после softmax | после отсечений |
|---|---|---|---|
| «окне» | 3,20 | 35,5 % | 35,5 % |
| «диване» | 2,80 | 23,8 % | 23,8 % |
| «подоконнике» | 2,50 | 17,6 % | 17,6 % |
| «столе» | 2,10 | 11,8 % | 11,8 % |
| «крыше» | 1,40 | 5,9 % | 5,9 % |
| «полу» | 1,10 | 4,4 % | 4,4 % |
| «клавиатуре» | -0,40 | 1 % | 1 % |
Остановка цикла — не механизм, а четыре разные причины, и только первая исходит от модели: токен
конца, max_tokens, стоп-строка, обрыв соединения. Стоп-строку и лимит модель не видит. «Модель
не дописала мысль» почти всегда означает «у вас маленький max_tokens», а не «модель растерялась».
Инференс: чем платят за каждый токен
Запрос к модели распадается на две фазы, и это не две половины одного действия, а две задачи с
разной арифметикой. Prefill прогоняет весь промпт одним параллельным проходом: матрица
[n × d_model] через все слои, упор в вычисления. Decode добавляет по одному токену за проход:
матрица [1 × d_model], и каждый раз ради одной строки нужно перечитать все 15 гигабайт весов из
памяти. Упор в пропускную способность памяти, а не в TFLOPS.
Отсюда парадокс, который я долго не мог принять: удвойте мощность чипа — время на токен не сдвинется; удвойте пропускную способность памяти — время сократится вдвое. У H100 и H200 один кристалл и одинаковое время до первого токена, а токены в секунду разные, потому что у H200 память быстрее. Промпт в N токенов обрабатывается за один проход, ответ в M токенов — за M проходов, и почти всё время запроса живёт в decode, даже когда промпт в разы длиннее ответа. Именно поэтому провайдеры берут за выходные токены дороже, чем за входные: это не маркетинг, а прямое отражение работы карты.
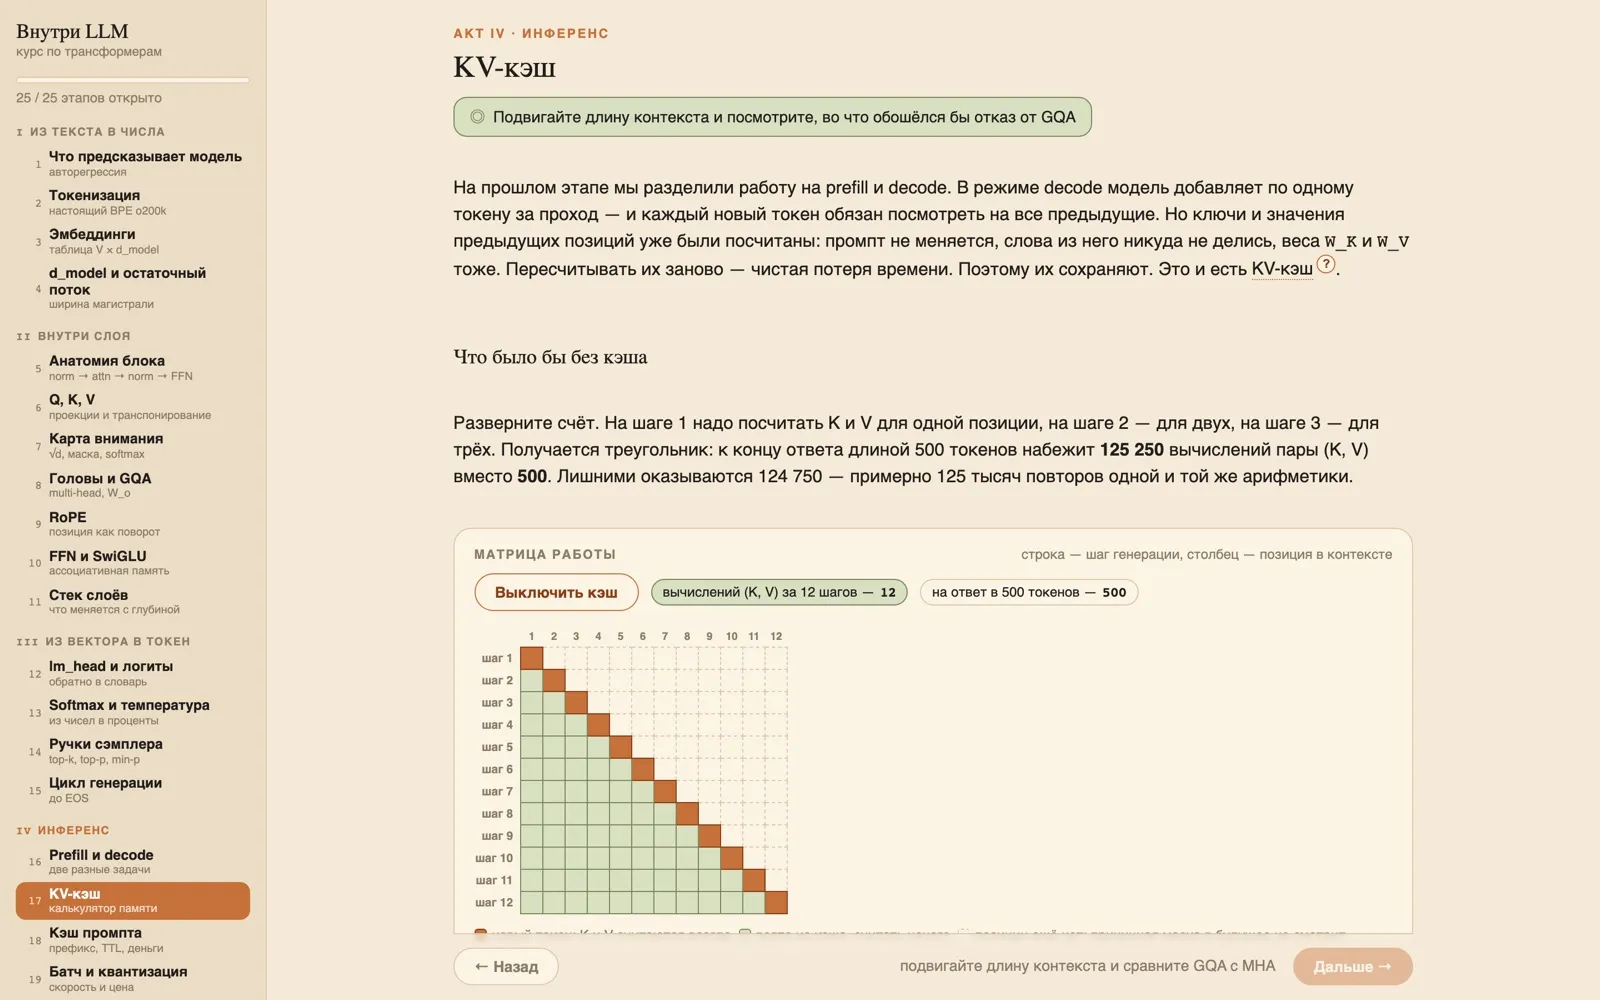
Каждый новый токен обязан посмотреть на все предыдущие, но их ключи и значения уже посчитаны: промпт не менялся, веса тоже. Пересчитывать их заново — треугольник лишней работы: на ответ в 500 токенов набежало бы 125 250 вычислений пары (K, V) вместо 500. Поэтому их сохраняют. Только K и V, каждого слоя, для каждой позиции. Запрос Q не кэшируется никогда: это одноразовый вопрос к прошлому.
Формула кэша линейна по всему подряд: 2 тензора × слои × KV-головы × d_head × байт на число × длина контекста. Никаких квадратов: квадратичность живёт в вычислениях внимания, а не в памяти под него. Для Llama 3 8B в bf16 это 2 × 32 × 8 × 128 × 2 = 131 072 байта на токен, ровно 128 КиБ; контекст в 8192 токена — ровно гибибайт. Без GQA, с 32 KV-головами вместо 8, было бы четыре. Единственный множитель в этой формуле, которым архитектор может распорядиться, — число KV-голов, и с ростом модели оно не растёт: у 405B голов 128, а KV-комплектов всё те же восемь.
Посчитайте сами. Обратите внимание, что число одновременных пользователей на карте упирается не в веса, а в кэш: веса на карте одни на всех, кэш — свой у каждого:
2 × 32 слоёв × 8 KV-голов × 128 × 2 Б = 131 072 Б на токен · GQA: в 4 раза меньше, чем было бы с MHA
- веса
- 15 ГиБ
- KV-кэш, 8K × 1
- 1 ГиБ
- итого
- 16 ГиБ
веса кэш · засечки — память одного ускорителя
Откуда берутся веса
«Веса модели» — зонтичный термин для всех обучаемых чисел сразу: таблица эмбеддингов, матрицы внимания и FFN каждого слоя, крошечные векторы нормализаций, выходная матрица. Склад с несколькими отделами, а не одна коробка, и «модель на 8 миллиардов параметров» складывает их все. Простой тест: если число одинаковое для всех пользователей — это параметр; если оно зависит от вашего текста — активация. Главная ловушка курса — «веса внимания». Тепловая карта softmax-а — активации, они родились из вашего промпта и умрут вместе с ответом. Проценты — результат, матрица — рецепт.
Обучение не объясняет модели, как правильно. Оно минимизирует одно число: взяли вероятность, которую модель дала настоящему следующему токену, взяли минус логарифм, усреднили по всем позициям. Ни в одном месте формулы не участвует «смысл» или «полезность ответа». Логарифм нужен, чтобы уверенная ошибка наказывалась несоизмеримо сильнее честного незнания: угадывать равномерно по словарю Llama 3 стоит 11,76 нат на токен, а уверенно ошибиться — 15–20.
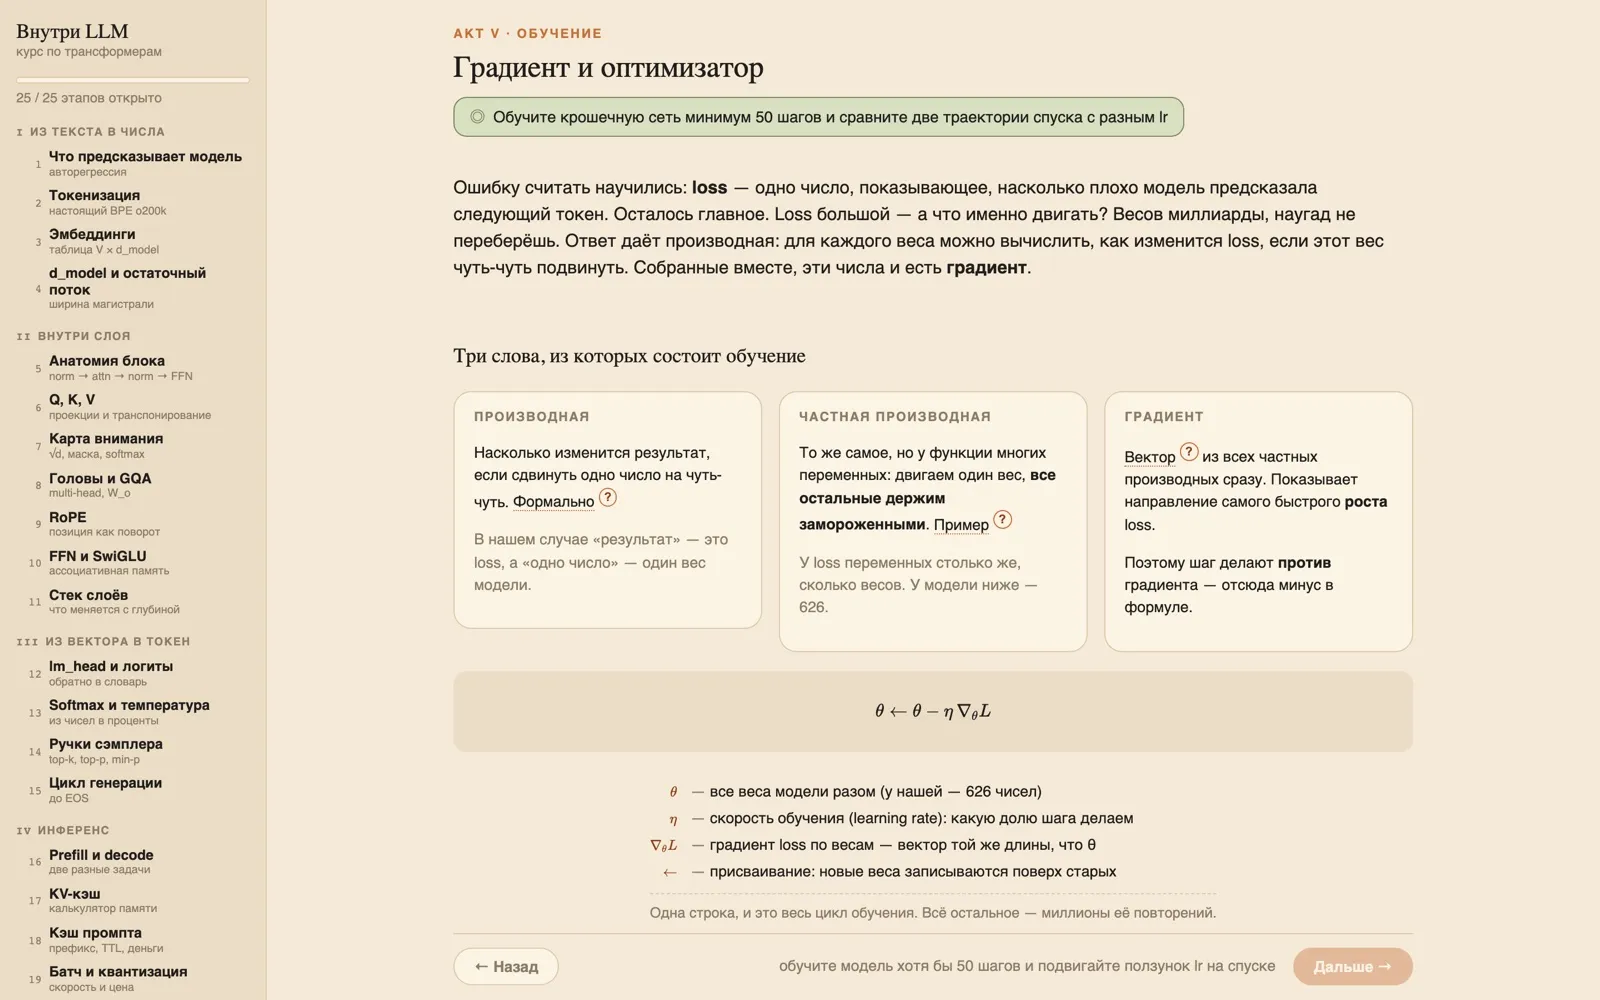
Дальше — миллионы одинаковых шагов: посчитать ошибку, узнать по градиенту, в какую сторону
подвинуть каждое число, подвинуть на чуть-чуть. В курсе это происходит по-настоящему: сеть из 626
весов на 69 парах слов, никакой подгонки чисел. Это же и главный ответ на вопрос «откуда берутся
эмбеддинги»: E — обычная матрица весов, и учится она тем же градиентом, что и всё остальное.
За один шаг двигаются только строки слов из батча, поэтому редкие токены в больших моделях
обучаются плохо.
Ассистент — не одна модель, а три стадии. Претрейн на 15 триллионах токенов даёт язык и факты, но выдаёт продолжение текста, а не ответ. SFT на десятках тысяч примеров «запрос → хороший ответ» учит формату диалога; RLHF или DPO на сравнениях пар — стилю, отказам, вежливости. Претрейн видит в 300 000 раз больше токенов, чем SFT, и съедает 99,5 % GPU-часов. Один и тот же факт модель знает уже на первой стадии: две следующие не добавляют ни одного нового, они учат форме. Поэтому дообучение на ваших регламентах даёт стиль регламентов, а конкретный пункт вспоминает через раз. Формат и поведение — дообучением, факты — контекстом.
И последнее число. Инференсу нужны веса, KV-кэш и активации одного слоя. Обучение держит на каждый вес пять чисел: сам вес, fp32-копию, градиент и два момента оптимизатора, 16 байт вместо двух, плюс активации всех слоёв. Полное дообучение Llama 3 8B требует 129 ГБ, и сами веса — лишь 11,6 % этой цифры. Поэтому дообучают адаптерами: LoRA с рангом 16 на матрицах внимания — это 13,6 миллиона обучаемых параметров, 0,17 % модели, и файл адаптера в 26 мегабайт.
Что осталось от магии
Токенизатор, таблица эмбеддингов, стек одинаковых блоков, одна матрица на выходе и один жребий. Всё, что казалось магией, оказалось умножением матриц, сложением и броском жребия в конце. Ни на одном шаге нет места, где модель сверяется с истиной: она считает, какое продолжение правдоподобно, и правдоподобно не значит верно.
Для меня главным результатом стали не формулы, а рефлексы. Когда коллега говорит «модель
тупит на длинных ответах», я теперь спрашиваю про max_tokens. Когда обсуждаем, сколько
пользователей выдержит карта, считаю KV-кэш, а не веса. Когда кто-то предлагает дообучить модель
на документации, спрашиваю, почему не контекст.
Если хочется получить эти рефлексы руками, а не текстом, курс открыт: 25 этапов, три-четыре часа, прогресс хранится в вашем браузере. Следующие статьи в этой теме — про другую сторону работы: как модель раскатать, чем она упирается в железо и во что это обходится.